Срок годности этой статьи
Сначала предупреждение. Область меняется так быстро, что любой текст о ней устаревает за квартал. За два года сменилось несколько поколений моделей, объём текста, который модель читает за один раз, вырос примерно в десять раз, а приёмы проверки, которые в прошлом году считались продвинутыми, теперь встроены в базовые продукты. Всё, что написано ниже, верно на сентябрь 2026 года. Через месяц какие-то утверждения могут потребовать уточнения. Мы будем обновлять текст по мере того, как будут меняться модели.
Инструментарий в условиях изоляции
Через это прошёл почти каждый. Сайт, о котором пишут все, на регистрации не принимает номер с +7. Карта не проходит. Аккаунт, заведённый через знакомого за границей, работает месяц-другой, а потом однажды перестаёт открываться. В условиях использования это сказано прямо: наша страна не входит в список стран, где сервис доступен. По сообщениям профильных изданий, в августе 2026 года Gemini перестал открываться с российских адресов даже у тех, кто до этого как-то пробивался. Anthropic осенью 2025-го объявил, что закрывает коммерческий доступ компаниям, которые контролируются из России, Китая, Ирана и Северной Кореи. Сервисы OpenAI у нас официально не работают с 2022 года. Обход ограничений нарушает их правила, и аккаунт могут закрыть в любой момент вместе со всем, что в нём накопилось.
Мы привыкли. Технология, о которой пишут все, для нас существует в пересказах и на чужих скриншотах.
А тем временем коллега, уехавший в Абу-Даби, или партнёр из Сингапура пользуется моделью так же буднично, как калькулятором. Для них это давно не новость, а рабочий инструмент: в проектировании, в юридической работе, в сметах, в кадрах. Отставание здесь измеряется не годами, а привычками. Кто три года не пользуется инструментом, тот перестаёт понимать, зачем он нужен, и это самое неприятное в изоляции.
SOHO AI мы делали как ответ на это. Мы не пытаемся заменить западные сервисы и не перепродаём чужой доступ. Задача проще и честнее: чтобы у нас можно было работать с ИИ так, как с ним работают везде. Из России, без VPN, с оплатой в рублях, на моделях, которые доступны нашему рынку, и, что для нас главное, с привязкой к нашей нормативной базе.
Доступ, впрочем, только половина дела. Со второй половиной, надёжностью, сложнее. О ней эта статья.
Чем это отличается от ведущих западных моделей
С точки зрения пользователя ведущие западные модели устроены одинаково. Одна модель, один ответ, один голос. Сегодня многие из них перед ответом ищут в сети и читают найденное, и для бытовых вопросов этого хватает. Когда ответ должен опираться на нормативный документ, а ошибка стоит денег, у такой схемы всё равно остаются три слабых места, и никакая инструкция в запросе их не закрывает.
Источник модель выбирает сама. Поиск приносит десяток страниц: пересказы, старые редакции, форумы, сайты консультантов. Какую из них взять за основу и считать ли её действующей, модель решает сама, и этот выбор внутри неё никто не сверяет с официальным текстом.
Цитата не сверена дословно. Даже найденный документ модель пересказывает своими словами. Кавычки в ответе создают ощущение точности, но не означают, что текст взят из действующей редакции буква в букву.
Один голос некому поправить. Что бы модель ни делала до ответа, в конце говорит она одна. Если она уверенно назвала не тот пункт или не ту редакцию, внутри системы нет никого, кто бы это заметил.
В SOHO AI ответ строится иначе, и различие тут не в интерфейсе, а в устройстве. На вопрос отвечают несколько независимых моделей, потом каждая обязана найти ошибки у другой, итог сводит арбитр, а затем сервер сверяет утверждения с первоисточником. Умнее от этого система не становится. Она становится проверяемой. Ниже мы объясним, почему такая конструкция вообще должна работать, и откуда взялась каждая её часть.
Шесть дел, которых не было
22 июня 2023 года федеральный судья Южного округа Нью-Йорка Кевин Кастел вынес решение по делу Mata v. Avianca. Само дело было обычным спором пассажира с авиакомпанией. Известным его сделали адвокаты истца. В меморандуме они сослались на шесть судебных прецедентов, и ни одного из них не смогли найти ни адвокаты ответчика, ни судья. Когда суд потребовал тексты решений, выяснилось, что все шесть придумал ChatGPT, вместе с названиями, номерами и цитатами. Адвокат под присягой рассказал, что спросил у ChatGPT, настоящие ли это дела, и получил ответ «да».
Штраф составил пять тысяч долларов. Сумма символическая, но за несколько недель дело попало во все курсы юридической этики.
Для нашей темы здесь важны две вещи. Модель не врала в человеческом смысле, она достроила правдоподобный текст, потому что именно этому её учили. И ошибку нашёл не алгоритм, а другая сторона, которая открыла базу данных и проверила. К этому мы ещё вернёмся.
Сколько ошибаются даже специализированные системы
Можно возразить, что это 2023 год и бытовой чат-бот, а с тех пор всё изменилось. Отчасти так. Но в мае 2024 года лаборатория RegLab Стэнфордского университета опубликовала исследование коммерческих юридических ИИ-систем. Речь о дорогих продуктах для профессионалов, в рекламе которых обещали отсутствие галлюцинаций. Исследователи взяли 202 юридических запроса, прогнали их через ведущие платформы и вручную, силами юристов, оценили каждый ответ.
Доля ответов с недостоверными утверждениями составила от 17 до 33 процентов в зависимости от системы. У чат-ботов общего назначения, по данным той же группы, она доходила до 69–88 процентов на юридических вопросах. Каждый шестой, а то и каждый третий ответ с ошибкой. Такому инструменту нельзя доверять без проверки.
У стэнфордской работы есть деталь, которая нам пригодится. Методику и критерии оценки исследователи зафиксировали до начала эксперимента, чтобы их нельзя было подогнать под результат. Мы сделали то же самое со своим реестром заданий, об этом ниже.
Почему нельзя просто спросить троих
Первая мысль, которая приходит в голову: если одна модель ошибается в трети случаев, спросим три и возьмём ответ большинства. Мысль старая. В 1785 году маркиз де Кондорсе доказал теорему о присяжных. Если каждый из независимых участников прав с вероятностью больше половины, то с ростом числа участников решение большинства становится всё точнее. Ключевое слово здесь «независимых».
В инженерии надёжности эту идею воплотили в N-версионном программировании. Алгирдас Авиженис в 1985 году предложил давать одну спецификацию нескольким командам, запускать полученные программы параллельно и брать результат голосованием. Если ошибки версий независимы, вероятность общего отказа падает очень быстро. Теорию проверили, и результат оказался неприятным.
В 1986 году Джон Найт и Нэнси Левесон дали одну задачу 27 программистам. Оказалось, что разные версии отказывают на одних и тех же входных данных гораздо чаще, чем предсказывает модель независимости. Люди ошибаются в одних и тех же трудных местах. Голосование такие ошибки не ловит, оно их узаконивает.
С языковыми моделями дело обстоит ещё хуже. Они обучены на пересекающихся данных, у них общие пробелы, и одну и ту же неточность они воспроизводят с одинаковой уверенностью. Три модели с общими пробелами повторят общую ошибку трижды и назовут её консенсусом.
Что придумали в MIT и чего не хватило
В 2023 году группа из MIT и Google описала подход, который назвали многоагентными дебатами. Идея в том, чтобы не голосовать, а спорить. Несколько экземпляров модели отвечают, потом каждый читает чужие ответы и пересматривает свой, и так несколько раундов. На задачах по арифметике, логике и фактам точность заметно выросла. Модели, которой приходится защищать ответ перед коллегами, труднее выдать случайный ответ.
Спор действительно ломает часть корреляции: модель, критикующая чужой текст, работает иначе, чем модель, которая пишет свой. Но у дебатов есть предел. Если все участники разделяют одно заблуждение о содержании документа, спор закончится единодушным и очень уверенным неверным ответом. Внешнего источника истины у моделей нет. А в деле Avianca ошибку нашли именно там, в базе судебных решений.
Отсюда конструкция, к которой мы пришли. Дебаты плюс первоисточник, в строгом порядке стадий.
Как устроен способ
Стадия первая: независимые ответы. Две модели (в рабочем контуре сервиса их три) получают один и тот же вопрос и отвечают, не видя друг друга. Если убрать независимость, всё остальное теряет смысл.
Стадия вторая: перекрёстная проверка. Каждая модель получает чужой ответ и обязана найти в нём ошибки, отметить верное и поставить оценку. Слово «обязана» здесь главное. Согласиться молча нельзя.
Стадия третья: арбитр. Одна из моделей сводит ответы и результаты проверки в итог. Роль арбитра переходит от одной модели к другой от задания к заданию, чтобы результат не зависел от того, кто судит.
Стадия четвёртая: сверка на сервере. Здесь работает уже не модель, а программа. Каждое утверждение итога, которое ссылается на документ, ищется в тексте этого документа в действующей редакции, цитаты сравниваются дословно, а то, чего в источнике нет, из итога убирается. Это единственная стадия, которая не может разделить заблуждение моделей, потому что сама моделью не является.
Стадия пятая: суммаризация. Промежуточные материалы сжимаются перед передачей между стадиями, иначе четыре обмена текстами превращают ответ в долгую и дорогую процедуру.
Мы рассчитываем, что такая схема даёт больше полностью верных ответов при тех же моделях и без их дообучения. Но рассчитывать и утверждать не одно и то же, и здесь мы сознательно останавливаемся.
Цифрам верить нельзя, проверке можно
Любую цифру можно нарисовать. Девяносто пять процентов точности печатаются на слайде за минуту, и никто в зале не встанет и не пойдёт проверять, откуда они взялись. Отрасль, в которой всё началось с шести выдуманных прецедентов, заслужила другую валюту доверия. Мы её и предлагаем: не результат, а эксперимент. Не таблицу, которую составили мы, а инструмент, на котором вы составите свою. Подключаете две модели, любые, хоть те, которым верите больше всего, нажимаете «запустить» и через двадцать минут своими глазами видите, что происходит с ошибками, когда машины начинают проверять друг друга. Это уже не наш рассказ. Это ваш протокол.
Тестовый стенд
Стенд открыт по адресу test.sohoai.ru. Вы подключаете две любые модели по своим ключам, браузер обращается к ним напрямую, ключи не покидают вашу вкладку, расход идёт по тарифам вашего поставщика. Внутри реестр из 150 правовых заданий с эталонами, зафиксированными до прогона, и отпечаток реестра пересчитывается прямо на странице. Через двадцать минут у вас свой протокол: сколько заданий верно решила каждая модель в одиночку и сколько они решили, проверяя друг друга. Стенд предоставляется как есть, результаты зависят от выбранных моделей и не являются показателями сервиса SOHO AI.
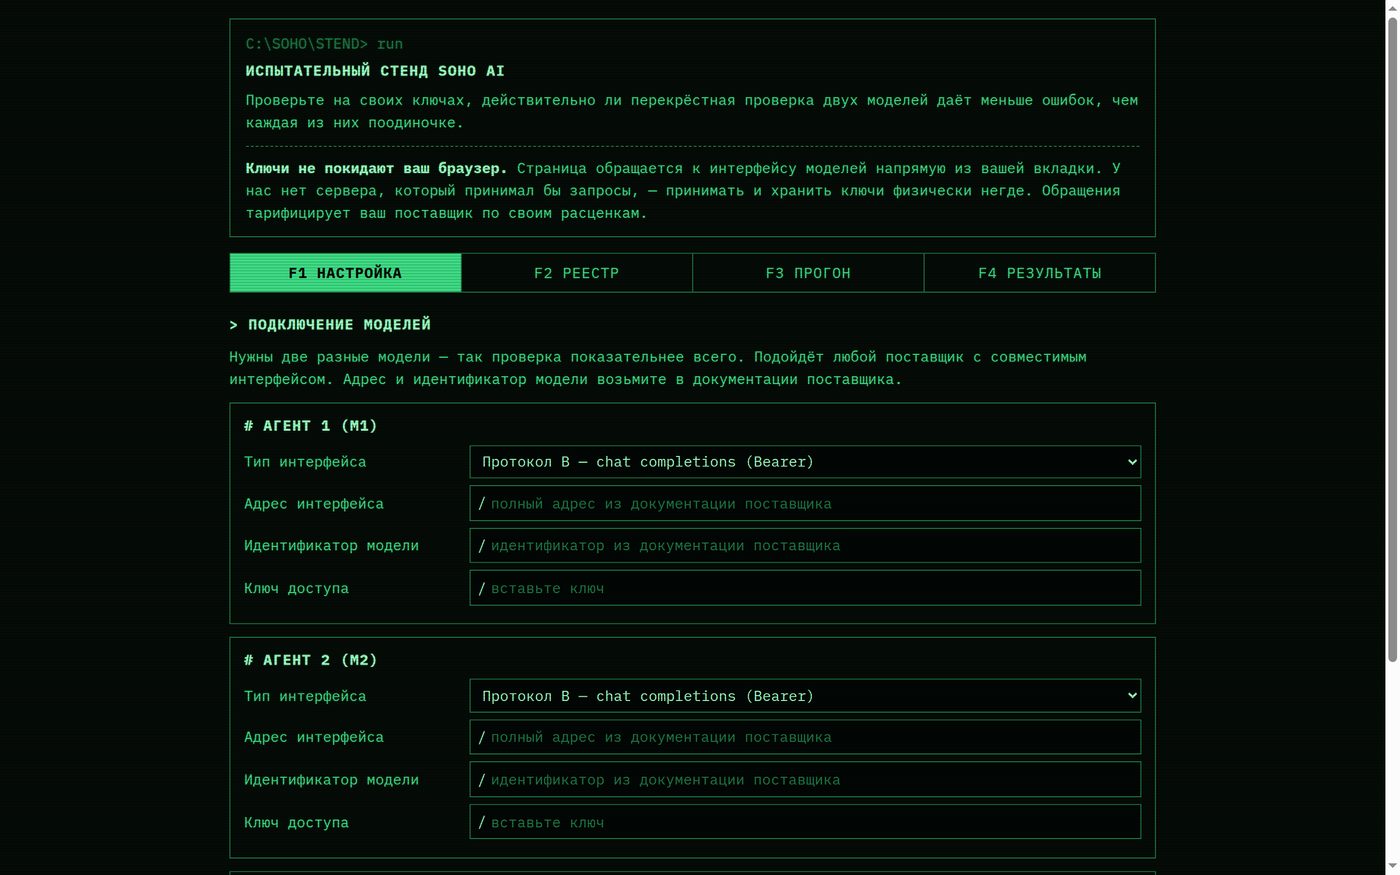
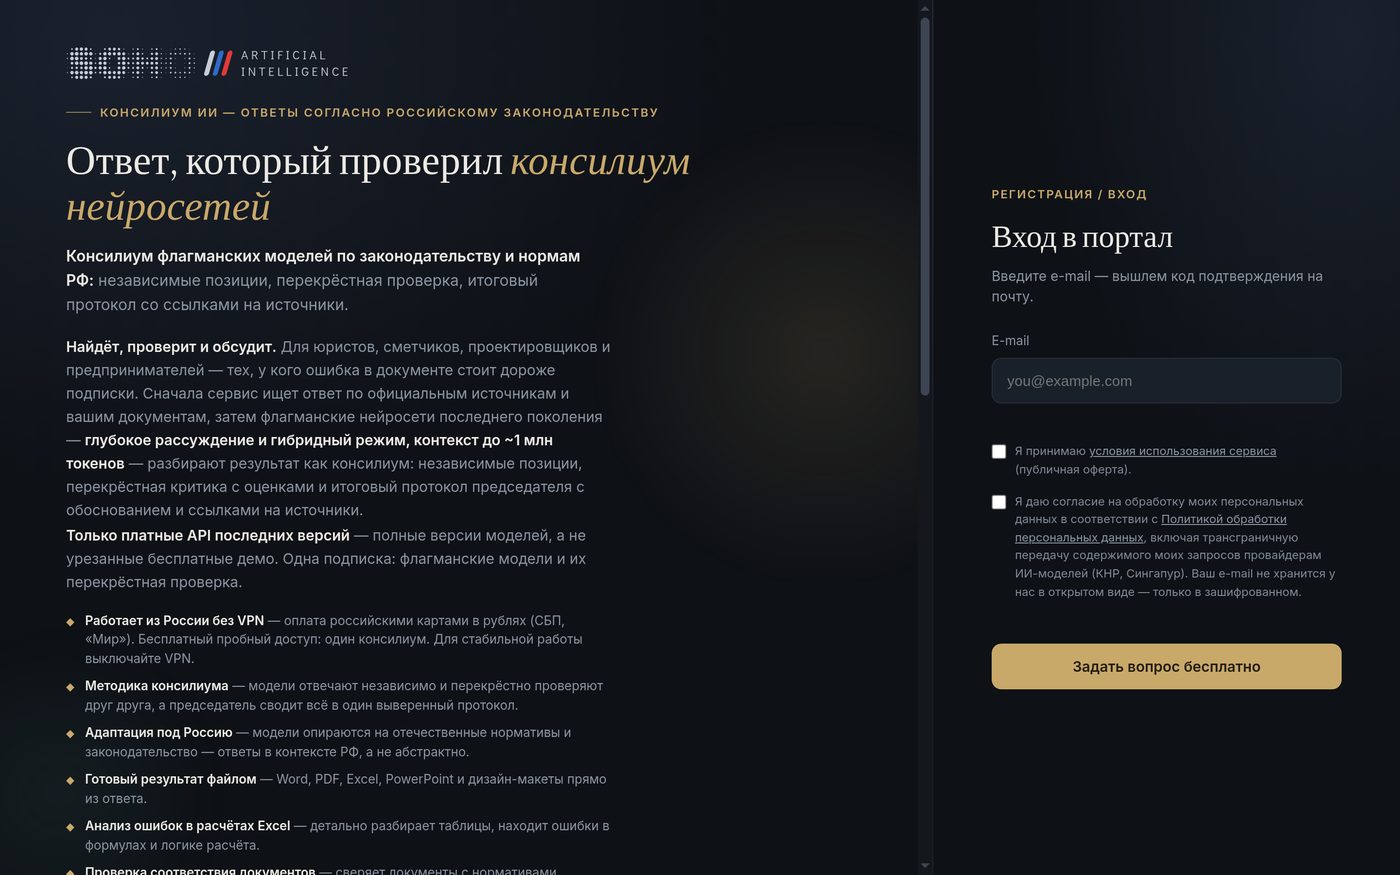
Сам сервис работает уже сейчас, первый консилиум — 99 ₽, условия на сайте: sohoai.ru.
Заключение
Граница, которая по-настоящему разделит людей в ближайшие годы, пройдёт не между странами. Она пройдёт между теми, кто научился работать вместе с машиной, и теми, кто решил, что его это не касается. Первые поручат агентам рутину, а потом и задачи посложнее. Освободившееся время они потратят на то, чего машина не умеет. Вторые будут делать всё это руками, как делали всегда, и какое-то время даже не заметят разницы. Разница накопится. Через несколько лет это будут два общества с разной скоростью, разной производительностью и разным набором достижений, живущие в одних и тех же городах и ходящие по одним улицам.
Выбор, к какому из них принадлежать, не делается когда-нибудь потом. Он делается сейчас, и делает его каждый сам.
Ответы ИИ, даже проверенные по первоисточникам, остаются аналитическим материалом, а не юридическим заключением. Но это материал, который можно проверить, а не принять на веру.
sohoai.ru. Выбор за вами.
Материал носит информационный характер и не является публичной офертой. Условия использования сервиса и стоимость определяются документами на сайте sohoai.ru и могут быть изменены. Состав моделей и функционал сервиса могут изменяться.
Сведения о сторонних сервисах, судебных делах и исследованиях приведены по открытым источникам по состоянию на 9 сентября 2026 года. Описание принципа работы одиночной модели относится к самому подходу и не является сравнением конкретных сервисов по каким-либо критериям или оценкой их качества. Упомянутые наименования принадлежат их правообладателям и приводятся в информационных целях.
Ответы, полученные с помощью сервиса или тестового стенда, являются аналитическим материалом, не заменяют консультацию специалиста и не являются юридическим заключением. Ответственность за решения, принятые на их основе, несёт пользователь.
Тестовый стенд работает в браузере пользователя. Ключи доступа и запросы направляются напрямую выбранным поставщикам моделей и не передаются автору или сервису SOHO AI. Выбор поставщиков, оплата их услуг и соблюдение их условий использования остаются на пользователе.
Источники
- Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023).
- Magesh V., Surani F., Dahl M., Suzgun M., Manning C. D., Ho D. E. Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools. Stanford RegLab, 2024; Journal of Empirical Legal Studies, 2025.
- Dahl M., Magesh V., Suzgun M., Ho D. E. Large Legal Fictions: Profiling Legal Hallucinations in Large Language Models, 2024.
- Du Y., Li S., Torralba A., Tenenbaum J. B., Mordatch I. Improving Factuality and Reasoning in Language Models through Multiagent Debate. ICML, 2024.
- Avizienis A. The N-Version Approach to Fault-Tolerant Software. IEEE Transactions on Software Engineering, 1985.
- Knight J. C., Leveson N. G. An Experimental Evaluation of the Assumption of Independence in Multiversion Programming. IEEE TSE, 1986.
- Condorcet. Essai sur l'application de l'analyse à la probabilité des décisions rendues à la pluralité des voix, 1785.